Влияние учёта электрического заряда атомов на точность предсказания взаимодействия Т-клеточных рецепторов с эпитопами программой MultiPASS
Влияние учёта электрического заряда атомов на точность предсказания взаимодействия Т-клеточных рецепторов с эпитопами программой MultiPASS

Аннотация
Цель: оценить влияние учёта электрического заряда атомов аминокислотных остатков пептидов на точность моделей связи «структура-активность» (SAR, structure-activity relationships) и расширить спектр прогнозируемых активностей разработанного ранее веб-сервиса TCR-Pred для предсказания взаимодействия Т-клеточного рецептора с эпитопом и главным комплексом гистосовместимости (MHC).
В качестве источника данных использовались обновленные базы данных IEDB, CEDAR, VDJdb, McPAS-TCR, PIRD от марта 2026 года. Классификационные модели SAR были созданы с использованием программы MultiPASS 2025. MultiPASS 2025 основан на модифицированном наивном Байесовском классификаторе и на описании структурных формул CDR3 (Complementarity-Determining Region 3) участков в виде дескрипторов многоуровневых атомных окрестностей (MNA, Multilevel Neighbourhoods of Atoms), как заряженных, так и незаряженных атомов.
Учёт заряда практически не повлиял на характеристики лучших моделей. Новые модели SAR для прогноза взаимодействия между Т-клеточными рецепторами и эпитопами/молекулами MHC имеют в сравнении с предыдущей версией более высокую точность (в среднем на 0,06 по величине ROC AUC) и расширенный спектр (в среднем в 2 раза) прогнозируемых активностей.
1. Введение
Т-лимфоциты распознают клетки, содержащие признаки чужеродной генетической информации, с помощью специализированных молекул на своей мембране — Т-клеточных рецепторов (T-cell receptor, TCR). Т-клеточный рецептор взаимодействует с комплексом «эпитоп-главный комплекс гистосовместимости» (major histocompatibility complex, MHC) своими участками, определяющими комплементарность (complementarity determining regions, CDR). Взаимодействие «Т-клеточный рецептор-эпитоп-главный комплекс гистосовместимости» (TCR-peptide-MHC, TCR-pMHC) является одним из ключевых событий, приводящим к развитию иммунного ответа. Предсказание ответа иммунных клеток на специфические антигены является одной из ключевых задач иммуноинформатики. Решение этой проблемы позволяет ускорить разработку биологических препаратов, повысить их терапевтическую эффективность и снизить затраты на создание средств диагностики и лечения. Для этих целей широко применяются вычислительные методы, алгоритмы и прогностические модели, используемые при рациональном дизайне вакцин и иммунодиагностических систем , . Экспериментально подтверждено, что наибольший вклад в распознавание эпитопов вносят участки CDR3 TCR. На протяжении последних 30 лет научные коллективы по всему миру собирают экспериментальные данные о взаимодействии TCR с эпитопами. Эти данные агрегируются в специализированные базы данных: одна из крупнейших — Immune Epitope Database (IEDB) содержит больше 250000 записей о взаимодействии последовательностей CDR3 TCR c эпитопами.
Современные подходы для прогноза взаимодействия TCR-pMHC в основном опираются на модели машинного обучения, включая глубокие нейронные сети. Данное направление активно развивается благодаря прогрессу в области искусственного интеллекта, . Однако, несмотря на достигнутые успехи, большинство современных моделей имеют относительно низкую точность и охватывают довольно узкий спектр эпитопов. Так, NetTCR-2.2 позволяет делать прогноз для 26 эпитопов со средней величиной ROC AUC 0,85. TCRex показывает похожие результаты на выборке IMMPREP2023, при этом способен делать прогноз для 100 эпитопов, . Доступные данные характеризуются очень низким видовым разнообразием, что ограничивает область применимости этих моделей.
Ранее нами был разработан веб-сервис TCR-Pred, который способен рассчитывать вероятность связывания ТCR с пептидным эпитопом и молекулами МНС и который не уступает своим аналогам. Наш подход использует модифицированный наивный Байесовский классификатор для построения моделей зависимости «структура-активность» (SAR) и основан на представлении белковой последовательности CDR3 в виде структурных формул, описанных набором дескрипторов многоуровневых атомных окрестностей (Multilevel Neighbourhoods of Atoms, MNA). Впервые для биологических макромолекул он был применен для предсказания сайтов фосфорилирования белков. Предсказание взаимодействия TCR-pMHC и сайтов фосфорилирования белков послужило подтверждением возможности применения подобных методов хемоинформатики для решения задач, связанных с оценкой свойств биологических макромолекул. С использованием данного подхода ранее также были созданы классификационные модели для предсказания патогенных вариантов аминокислотных замен, приводящих к лекарственной устойчивости, сайтов ацетилированияи вторичных структур белка, , , . Целью данного исследования являлось изучение влияния учёта электрического заряда атомов в описании структурных формул аминокислотных остатков пептидов на качество прогноза и обновление моделей TCR-Pred с учетом новых экспериментальных данных.
2. Методы и принципы исследования
Подготовка данных и построение моделей были автоматизированы с использованием Nextflow v. 25.04.06 и Python 3.10. Часть вычислений проводилась на базе инфраструктуры высокопроизводительного кластера Алдан3 вычислительного центра НИИ Трансляционной медицины ФГАОУ ВО РНИМУ им. Н.И. Пирогова (Пироговский Университет). Для построения моделей были использованы сведения, извлечённые из баз данных IEDB, CEDAR, VDJdb, McPAS-TCR, PIRD, , , . Исходные выборки были скачаны 21 марта 2026 года. Были использованы следующие критерии фильтрации:
Общие правила: Наличие публикации (литературной ссылки). Результат взаимодействия между TCR и pMHC — положительный. Цепь CDR3 — альфа и/или бета. Корректные последовательности CDR3 (записанные в однобуквенном формате из 20 протеиногенных аминокислот). Организм-хозяин CDR3 – Homo sapiens (человек) или Mus musculus (мышь).
Данные о взаимодействии «Т-клеточный рецептор-эпитоп»: Корректная последовательность эпитопа. Эпитопы без химических модификаций.
Данные о взаимодействии «Т-клеточный рецептор — MHC аллель»: Первый или второй класс MHC (для моделей «Т-клеточный рецептор-эпитоп» эта информация может быть пропущена). Аллель MHC записана до конкретного белкового продукта (если была дополнительная информация, она была удалена).
Данные были сгруппированы в зависимости от типа цепи CDR3 (альфа или бета), организма-хозяина (человек или мышь) и типа прогнозируемой активности (эпитоп или аллель MHC) во всех возможных сочетаниях. При объединении данных были удалены записи-дубликаты. Аллели MHC приведены к общему номенклатурному виду с помощью библиотеки mhcgnomes . Дубликаты выявлялись по совпадению столбцов со структурой (CDR3) и активностью (эпитоп или MHC). Получившиеся таблицы были преобразованы в Structure-Data Format (SDF) файлы с помощью специальной программы, разработанной авторами, . В результате были сгенерированы SDF файлы, содержащие два типа структур: с полностью заряженными аминокислотными остатками и полностью нейтральными (такое представление было использовано при создании первой версии веб приложения TCR-Pred ).
Для построения моделей взаимодействия «Т-клеточный рецептор — эпитоп» и «Т-клеточный рецептор — MHC» была использована модифицированная версия программы MultiPASS (версия 2025 года), . MultiPASS работает на основе усовершенствованного алгоритма наивного Байесовского классификатора и использует представление структурных формул последовательностей CDR3 в виде дескрипторов многоуровневых атомных окрестностей (Multilevel Neighborhoods of Atoms, MNA). Принцип построения дескрипторов MNA представлен на рисунке 1. MultiPASS рассчитывает вероятности, что вещество будет активным (Pa) по отношению к некоторой мишени, и вероятность, что будет неактивно (Pi) по отношению к ней. Итоговый прогноз представляет собой разность этих вероятностей (Pa-Pi) и принимает значения в интервале от -1 до 1. Чем выше эта величина, тем выше вероятность, что исследуемое вещество обладает прогнозируемой активностью (взаимодействием с конкретным эпитопом или MHC аллели).
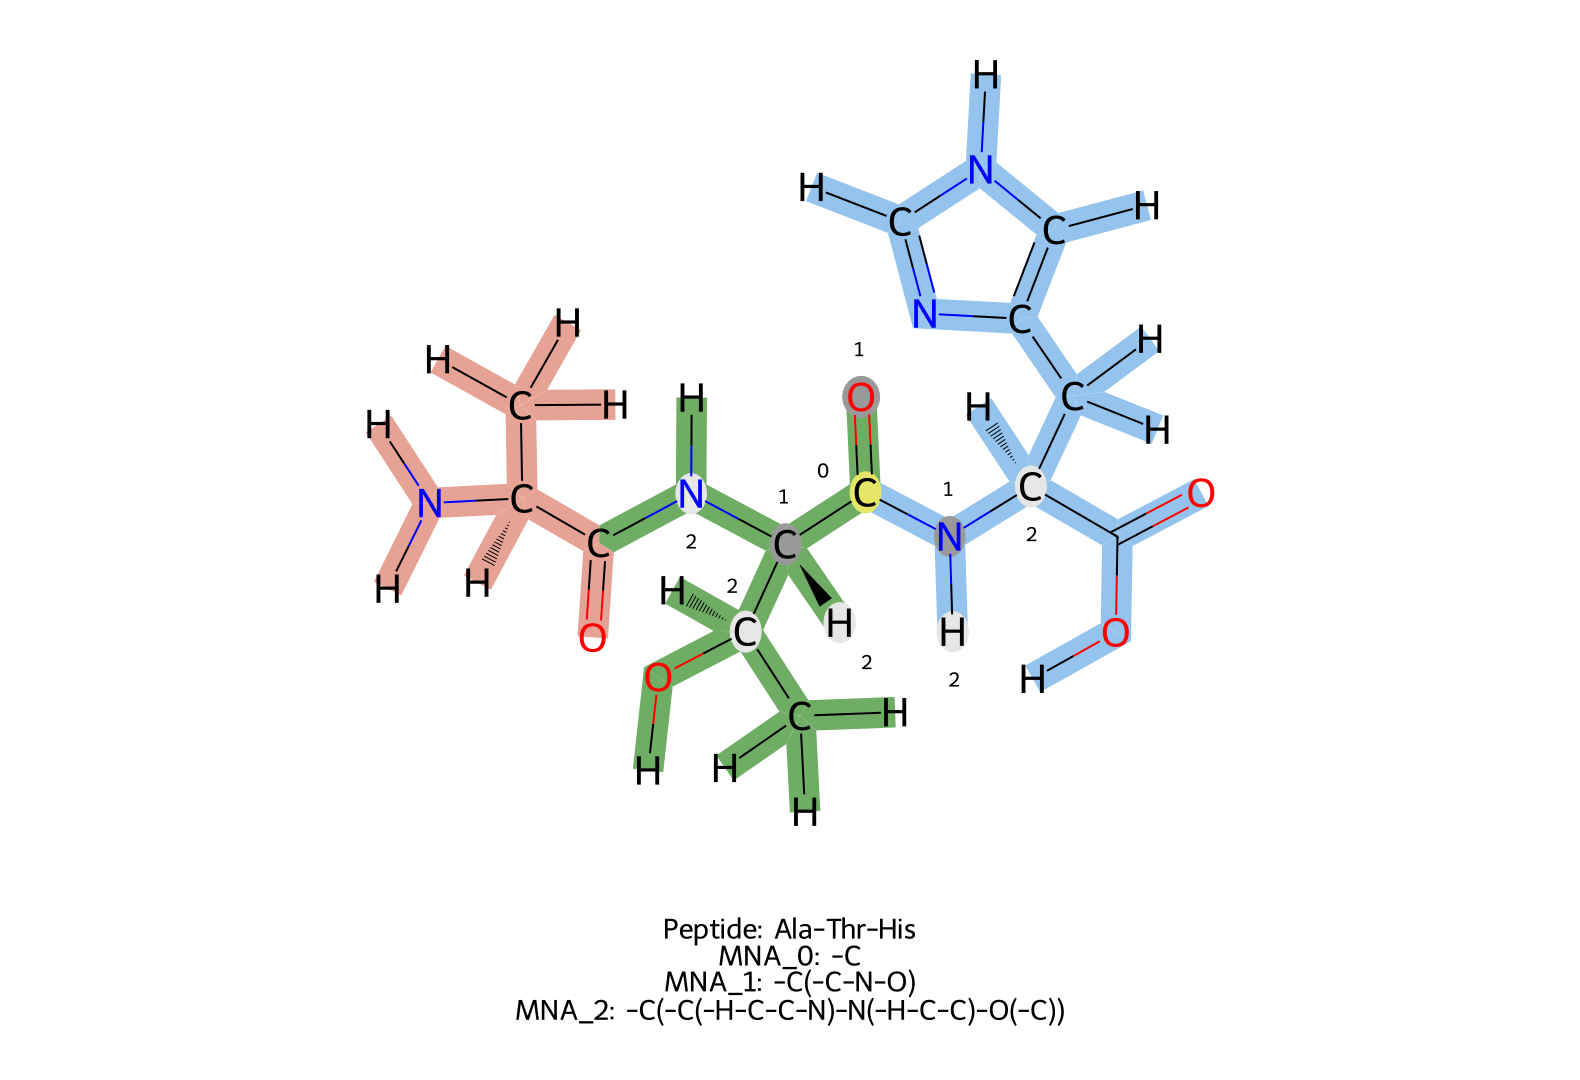
Принцип генерации дескрипторов многоуровневых атомных окрестностей (MNA) для карбоксильного атома углерода треонина
выделен светло-жёлтым, номер «0»
Модели SAR были созданы для каждого SDF файла с использованием максимального уровня (далее — просто «уровня») дескрипторов от 3 до 12. Оценка качества моделей производилась в процедуре перекрёстной проверки с разбиением на 5 частей с помощью метрики площади под кривой оперативной характеристики приемника (ROC AUC). Модели были отобраны по двум критериям. Во-первых, ROC AUC должен быть больше или равен 0,7. Второй критерий, минимальное количество пептидов участков CDR3 TCR в выборке, равен 3 последовательностям. Оптимальный уровень дескрипторов MNA равен минимальному уровню, при котором достигается максимальная медианная величина ROC AUC или очень близкая к нему. В случае затруднения в выборе лучшей модели по величине точности учитывали максимальное количество эпитопов или MHC аллелей, для которых можно было делать предсказание соответствующей моделью — широта спектра активностей. Таким образом, лучшими считались модели SAR, обладающие максимальными значениями как медианной ROC AUC, так и широты спектра. В случае незначительных отклонений между моделями с учетом зарядов атомов и без него приоритет отдавался последним, так как хранение заряда увеличивает размер файлов выборок и моделей, приводя к повышению нагрузки на работу сервера.
3. Основные результаты
3.1. Характеристика данных
В таблице 1 представлены характеристики обучающих выборок старой (v.2023) и новой версии (v.2026) TCR-Pred. В новой версии в 1,5–2 раза больше CDR3 последовательностей, последовательностей эпитопов и аллелей MHC. Этот рост количества данных может быть связан как с обновлением баз, так и со смягчением критериев отбора. Так, из критериев фильтрации была исключена «каноничность» последовательности CDR3 — то есть требование наличия консервативного цистеина на N-конце и фенилаланина на C-конце. Наблюдается небольшое снижение числа последовательностей для человеческих бета-цепей CDR3. Это может быть связано с обновлением и уточнением информации в самих базах данных. Для определения оптимальных параметров моделирования итоговые обучающие выборки были разбиты в зависимости от типа цепи CDR3 и организма-хозяина CDR3 во всех возможных сочетаниях. Выборки по классам MHC делить не стали, так как из-за этого значительно падает общая точность прогноза вследствие уменьшения объема обучающей выборки.
Информация об обучающих выборках предыдущей и новой версии после обработки с разбиением по организму-хозяину и типу цепи
данные для моделей предсказания активности к эпитопам и MHC обрабатывались отдельно, поэтому у них отличается количество записей
Количество уникальных структур в моделях | v.2023 | v.2026 | |||||||
Человек | Мышь | Человек | Мышь | ||||||
α | β | α | β | α | β | α | β | ||
CDR3 – эпитоп | CDR3 | 35616 | 141500 | 1604 | 3014 | 72630 | 134026 | 3401 | 6156 |
Эпитоп | 799 | 1257 | 96 | 123 | 1865 | 2052 | 148 | 171 | |
CDR3 – MHC | CDR3 | 31066 | 47639 | 1462 | 2550 | 72630 | 134026 | 3401 | 6156 |
MHC | 76 | 88 | 11 | 12 | 121 | 146 | 11 | 14 | |
Обращает на себя внимание, что активность Т-клеточных рецепторов изучена для малого разнообразия возможных эпитопов. На рисунке 2 представлено распределение объёма положительных примеров в обучающих выборках для конкретной активности (эпитопа/аллель MHC). Базы данных практически не содержат отрицательных примеров. MultiPASS принимает все примеры, которые не отмечены как положительные для данной активности, за отрицательные. Крайне мало эпитопов имеет большое количество (> 100) положительных примеров (взаимодействующих последовательностей CDR3), а половина всех имеющихся эпитопов/аллелей MHC имеет не более 2–3 положительных примеров.
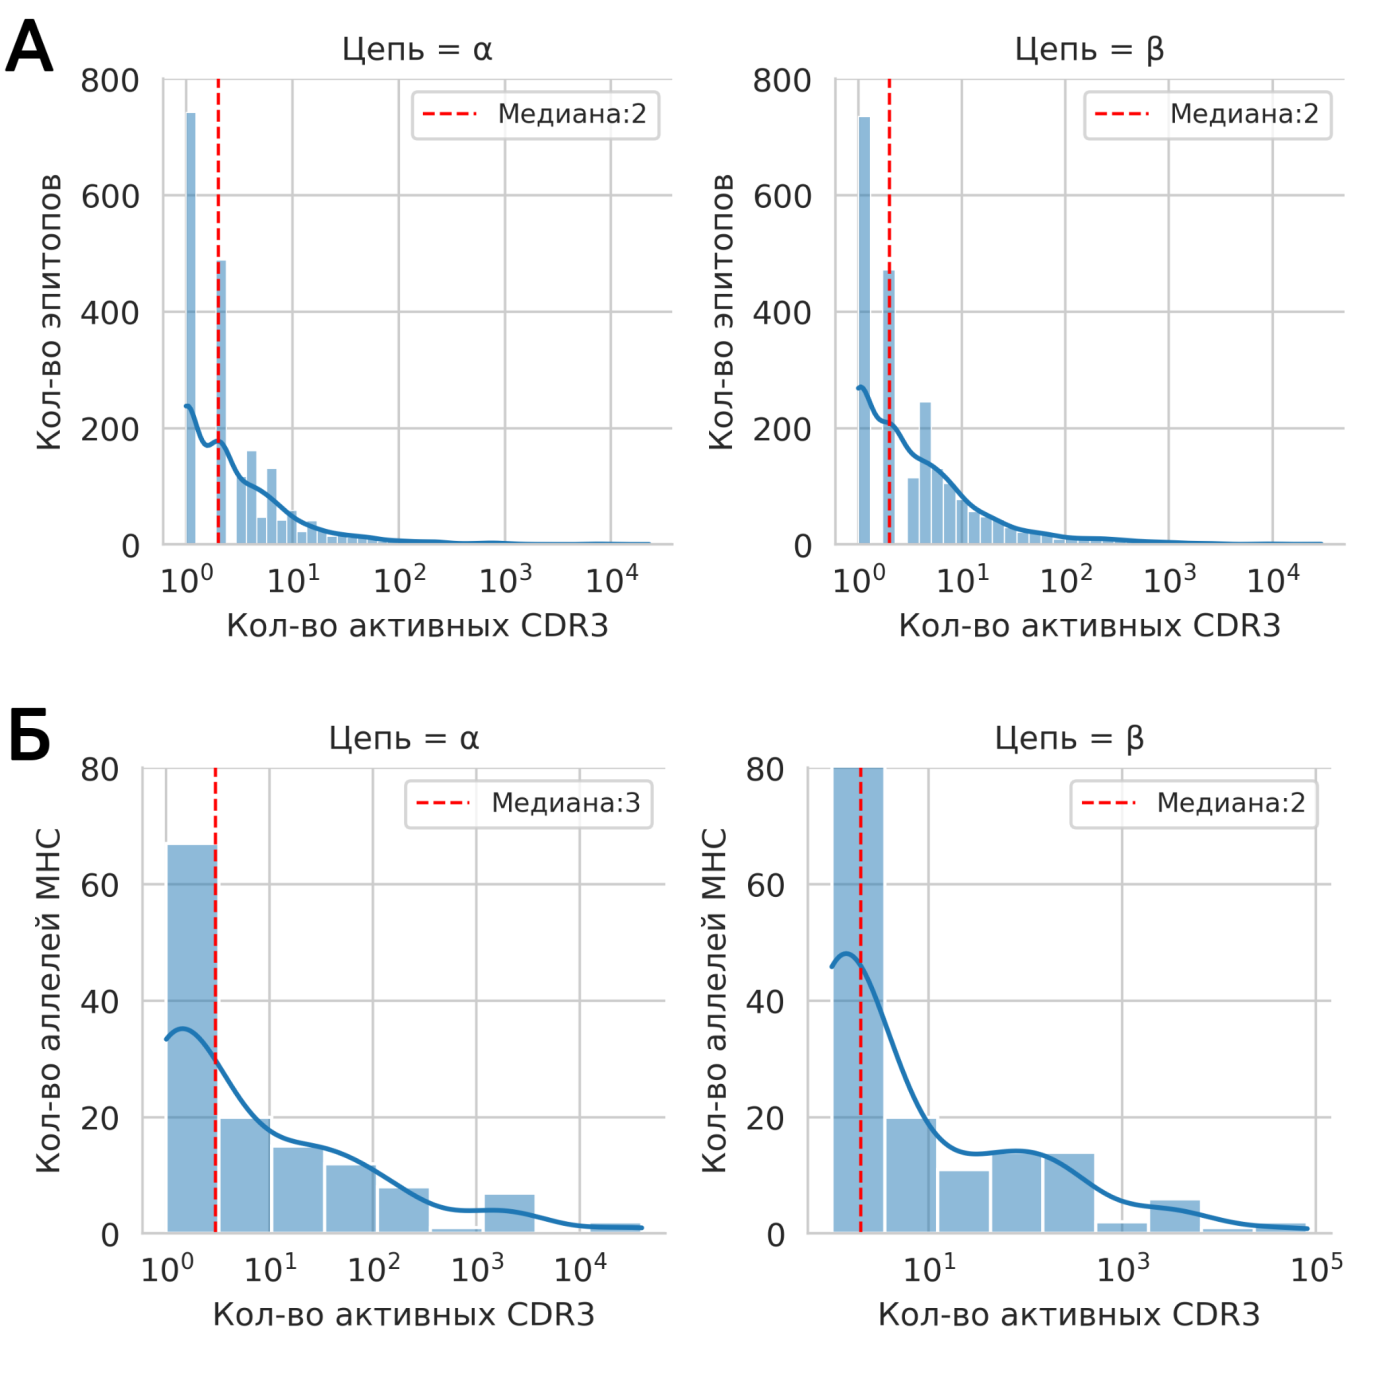
Гистограммы распределения количества последовательностей CDR3, взаимодействующих с конкретным эпитопом/аллелем МНС в обучающих выборках с разбиением по цепи CDR3:
А – для эпитопов; Б – для аллелей MHC; ось ординат – количество эпитопов/аллелей МНС; ось абсцисс – число CDR3-последовательностей на эпитоп/аллель MHC; синяя линия – ядерная оценка плотности распределения; красная линия – отметка медианы распределения
Перед построением моделей SAR была выдвинута гипотеза, что учёт электрического заряда атомов аминокислотных остатков в структурных формулах последовательностей CDR3 должен улучшить медианную точность моделей SAR. Для проверки этой гипотезы были сформированы два вида SDF файлов, с указанием заряда атомов в структурах аминокислотных остатков и без указания заряда. Для обоих видов SDF файлов были проведены одинаковые процедуры обучения, валидации и отбора лучших моделей SAR. Моделям SAR были присвоены названия заглавными буквами на английском языке в соответствии с использованной выборкой в следующем формате: цепь_активность_вид, например BETA_EPITOPE_MOUSE. Результаты сравнения представлены на рисунке 3. Из приведенных на рисунке 3 данных видно, что значимого улучшения медианной точности предсказываемых эпитопов или MHC аллелей, так же как и увеличения их количества, не наблюдается при добавлении информации о заряде молекул. Диаграммы на рисунке 3 построены по активностям, для которых удалось провести процедуру перекрёстной проверки. Для моделей SAR ALPHA_EPITOPE_HUMAN, BETA_EPITOPE_HUMAN количество эпитопов, прошедших перекрёстную проверку, не возрастало монотонно. Для дальнейших экспериментов использовались модели SAR без учёта зарядов атомов, потому что файлы таких выборок и моделей SAR занимают меньше места на диске. Следует отметить, что на диаграммах показаны результаты пятикратной кросс-валидации, поэтому количество активностей, которые могут предсказывать модели SAR несколько выше. По имеющимся диаграммам были выбраны оптимальные уровни дескрипторов MNA. Для каждого уровня MNA дескрипторов была проведена проверка статистической значимости различий между распределениями значений ROC AUC был использован тест Манна-Уитни из библиотеки scipy для языка программирования Python с параметрами по умолчанию. Этот критерий был выбран, так как закон распределения ROC AUC в нашем случае неизвестен и не симметричен. Из-за большого количества тестирований поправка Бенджамини-Хохберга, реализованная в этой же библиотеке, с параметрами по умолчанию была использована для корректировки p-значений. Ни на одном из уровней MNA дескрипторов, ни для одной из моделей не было найдено статистически значимых отличий между заряженными и нейтральными дескрипторами. Подробная информация приложена в дополнительных материалах, таблица 1.
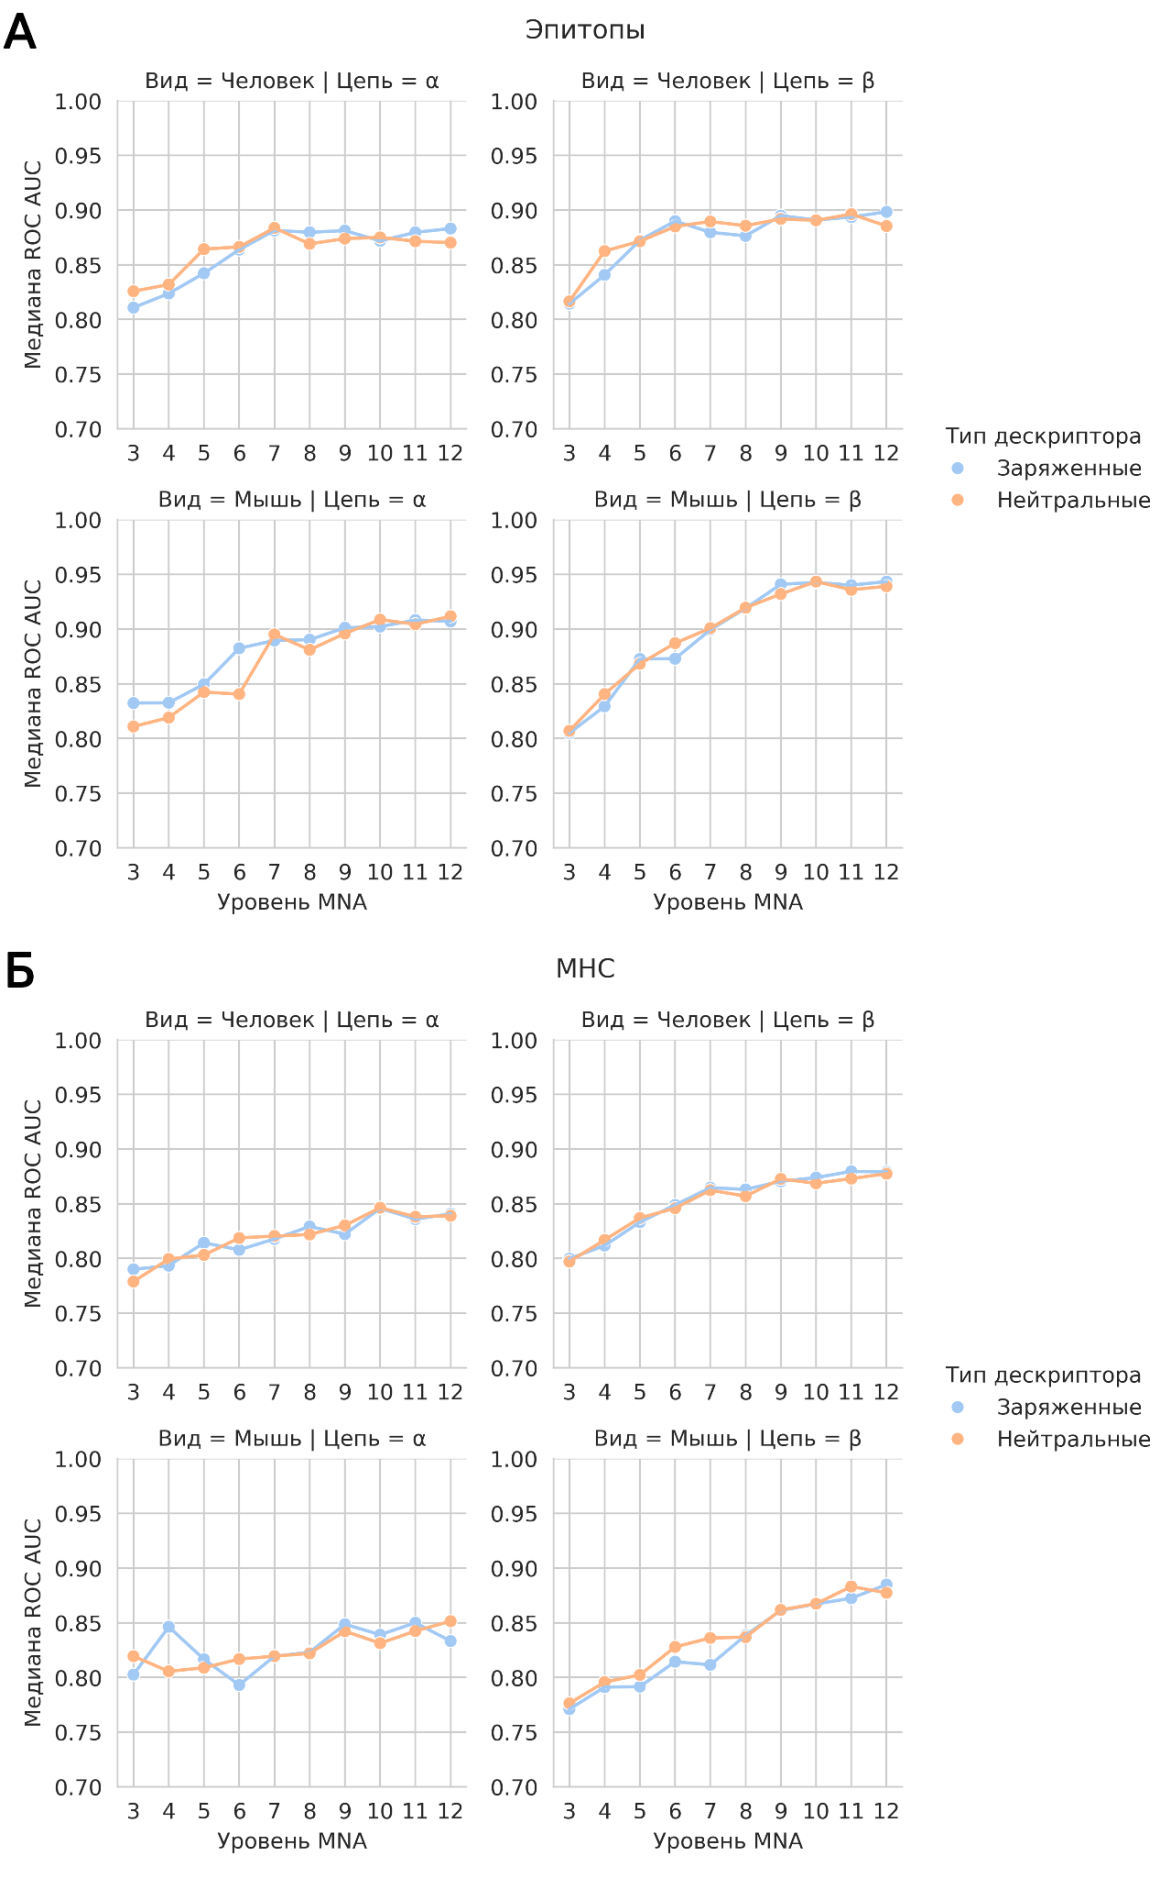
Диаграммы зависимости медианной точности прогноза для эпитопов (А) и МНС (Б) по результатам пятикратной кросс-валидации от уровня дескрипторов MNA для моделей SAR с учётом зарядов атомов и без него
Для первоначального сравнения моделей SAR разных версий мы отобрали только те активности, которые присутствуют в обеих версиях. Результаты такого сравнения представлены на рисунке 4. Новые версии лучших моделей SAR по медианной точности при пятикратной кросс-валидации превзошли все старые, за исключением ALPHA_EPITOPE_MOUSE. Для общего сравнения качества моделей SAR было проведено сравнение версий на всем спектре активностей. Характеристики моделей SAR при оптимальном значении уровня дескрипторов MNA представлены в таблице 2. Из приведенных в таблице 2 данных видно, что новые версии моделей (v.2026) превосходят старые (v.2023) по спектру активностей и медианной точности. Исключение составляет модель ALPHA_EPITOPE_MOUSE, где наблюдается расхождение, однако мы считаем, что уменьшение медианного AUC на 0,05 не так значимо, как расширение спектра активностей в 2 раза, с 13 до 28 MHC аллелей. Для некоторых моделей SAR, таких как BETA_EPITOPE_HUMAN, наблюдается рост количества предсказываемых эпитопов в 6 раз. Для большинства моделей SAR получилось добиться значительного прироста точности. Статистически значимые отличия в распределениях ROC AUC найдены в 6 из 8 типах моделей (исключая ALPHA_EPITOPE_MOUSE, BETA_MHC_MOUSE) в 36 точках (из 80). Для BETA_EPITOPE_HUMAN, BETA_EPITOPE_MOUSE различия наблюдаются практически на каждом уровне MNA дескрипторов. Подробная информация приложена в дополнительных материалах, таблица 2.
Сравнительная характеристика двух версий TCR-Pred
жирным шрифтом отмечены значения параметров, превосходящие такие же в другой версии для конкретной модели SAR
Модель SAR | Версия | Оптимальный уровень дескрипторов MNA | Количество активностей | Медиана ROC AUC |
ALPHA_EPITOPE_HUMAN | v.2023 | 10 | 97 | 0,8054 |
v.2026 | 10 | 540 | 0,8750 | |
BETA_EPITOPE_HUMAN | v.2023 | 9 | 196 | 0,7908 |
v.2026 | 9 | 803 | 0,8919 | |
ALPHA_MHC_HUMAN | v.2023 | 7 | 20 | 0,8233 |
v.2026 | 10 | 44 | 0,8464 | |
BETA_MHC_HUMAN | v.2023 | 10 | 28 | 0,7849 |
v.2026 | 9 | 53 | 0,8727 | |
ALPHA_EPITOPE_MOUSE | v.2023 | 5 | 13 | 0,9583 |
v.2026 | 10 | 28 | 0,9086 | |
BETA_EPITOPE_MOUSE | v.2023 | 9 | 42 | 0,8463 |
v.2026 | 10 | 45 | 0,9434 | |
ALPHA_MHC_MOUSE | v.2023 | 6 | 7 | 0,7865 |
v.2026 | 9 | 8 | 0,8423 | |
BETA_MHC_MOUSE | v.2023 | 8 | 7 | 0,7539 |
v.2026 | 11 | 9 | 0,8831 |
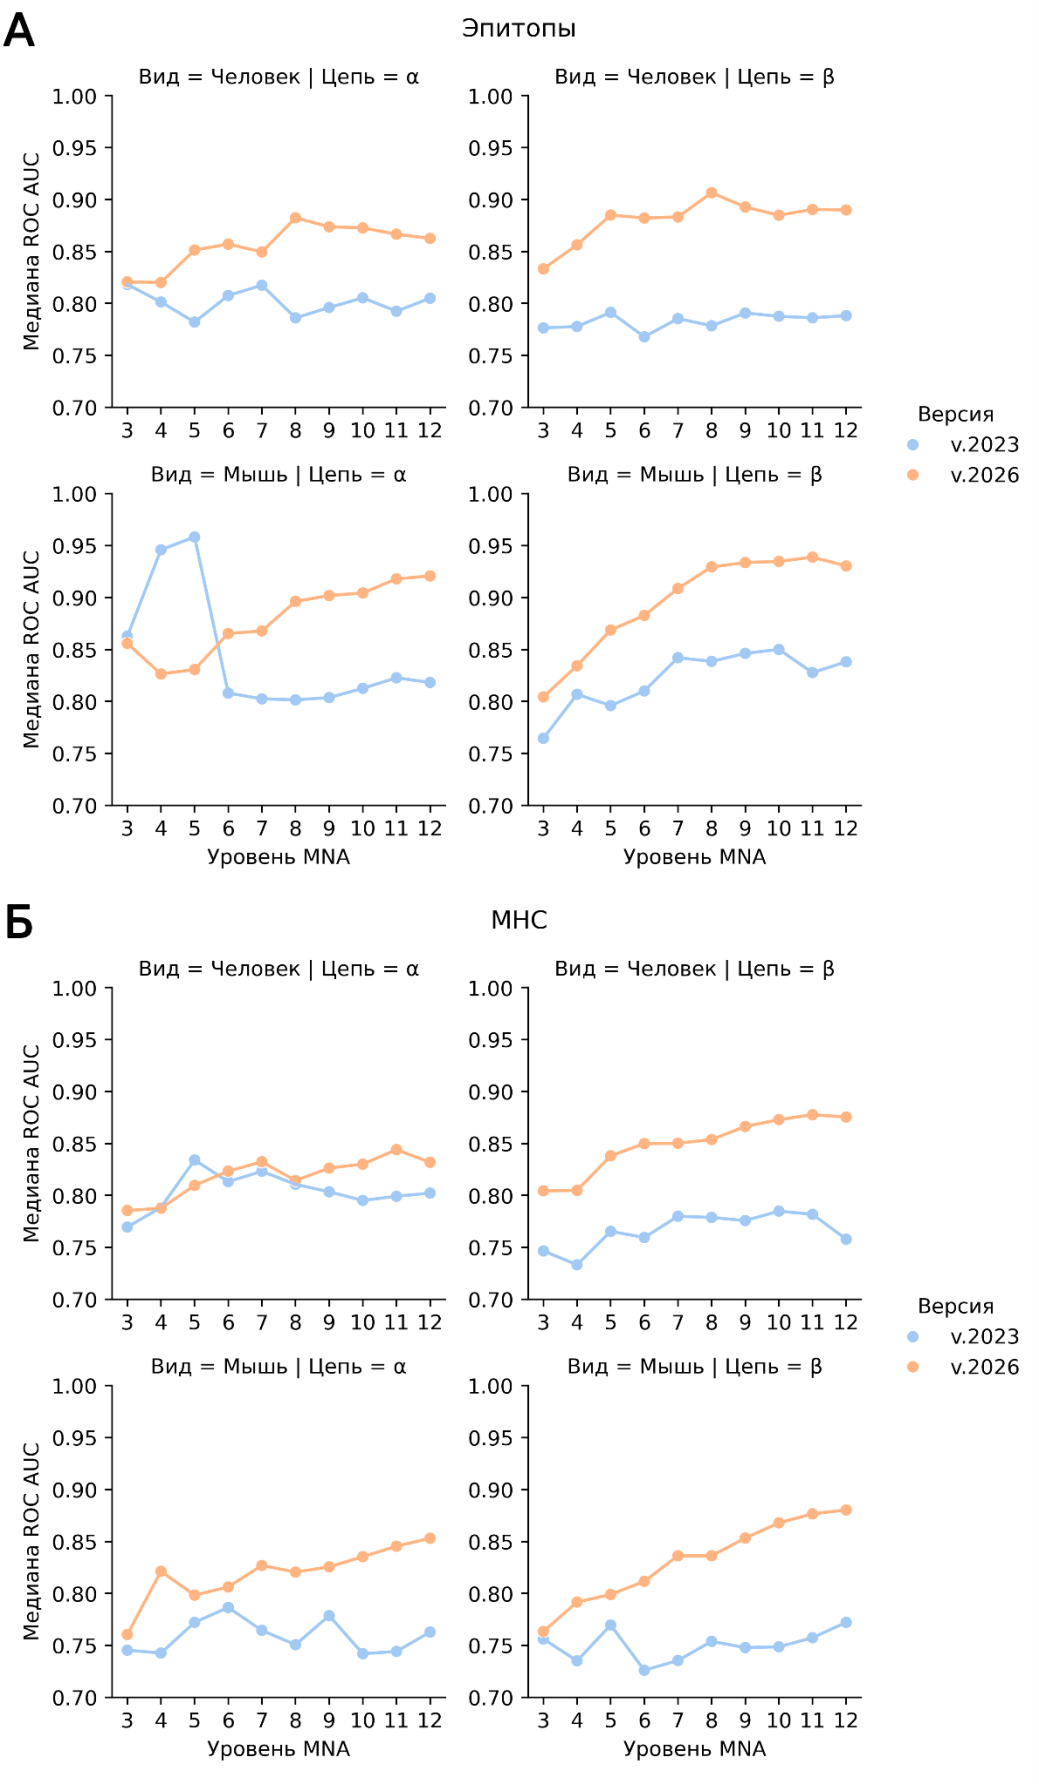
Диаграммы зависимости медианной точности прогноза по результатам пятикратной кросс-валидации от уровня дескрипторов MNA для старой и новой версии моделей SAR:
А – для эпитопов; Б – для МНС
диаграммы построены с использованием только тех активностей, которые являются общими для двух версий
4. Обсуждение
Предсказание взаимодействия рецепторов адаптивного иммунитета с эпитопами в настоящий момент является трудной задачей. Экспериментально эти взаимодействия изучены для малого количества эпитопов, причем для большинства из них известно небольшое количество положительных примеров последовательностей, взаимодействующих с ними CDR3 участков Т-клеточных последовательностей, при этом нет информации об однозначно отрицательных примерах, что затрудняет построение классификационных моделей. За три года произошел существенный рост количества экспериментальных данных, что позволило в новой версии TCR-Pred построить отдельные модели для человека и мыши. Увеличить количество данных также помогла их менее строгая фильтрация. В то же время, данное исследование показало, что учёт дополнительной информации, такой как электрический заряд атомов аминокислотных остатков фрагментов белков, не приводит к повышению статистически значимого количества более точных моделей. Такой результат является неожиданным, потому что электростатические взаимодействия играют важную роль при белок-белковых взаимодействиях. Вполне вероятно, что в текущем виде MNA дескрипторы уже неявно учитывают электростатические взаимодействия. Кроме того, теоретические расчеты указывают на то, что гидрофобные взаимодействия между T-клеточным рецептором и эпитопом играют более важную роль, чем кулоновские взаимодействия . Несмотря на то, что с точки зрения медианной точности прогноза разница между моделями, созданными с учетом заряда аминокислотных остатков и без их учета несущественна, для отдельных эпитопов и MHC аллелей использование зарядов атомов аминокислотных остатков фрагментов белков приводило к большей точности моделей. Это можно использовать для дальнейшего совершенствования веб-приложения в будущем.
Отдельно стоит отметить, что прогноз взаимодействия Т-клеточных рецепторов с эпитопами, которые отсутствовали в обучающей выборке, остаётся нерешённой задачей. Хемоинформатический подход в представлении белковых последовательностей в виде молекулярных дескрипторов имеет большой потенциал для обхода этого ограничения, а также для решения обратной задачи — подбор последовательностей рецептора под конкретный эпитоп. В дальнейшем мы продолжим совершенствовать TCR-Pred в направлении увеличения широты предсказываемых активностей, решения проблемы «неизвестных эпитопов» и создания REST API интерфейсов для Python и R.
5. Заключение
В данной работе было показано, что учёт информации о заряде атомов в описании структурных формул аминокислотных остатков CDR3 TCR практически не влияет на точность прогноза активности Т-клеточных рецепторов по отношению к эпитопам и аллелям MHC.
Также нами было обновлено веб приложение TCR-Pred, в котором значительно расширился спектр предсказываемых эпитопов и MHC аллелей, а также для большинства моделей повысилась медианная точность.
5.1. Доступность данных и исходного кода
Исходный код подготовки и анализа данных доступен по адресу github.com/SmirnygaTotoshka/TCRpred. Программа MultiPASS доступна по обоснованному запросу. Базы данных, используемые в работе, являются открытыми и общедоступными. Веб приложение TCR-Pred является свободно доступным (way2drug.com/TCR-Pred/).